
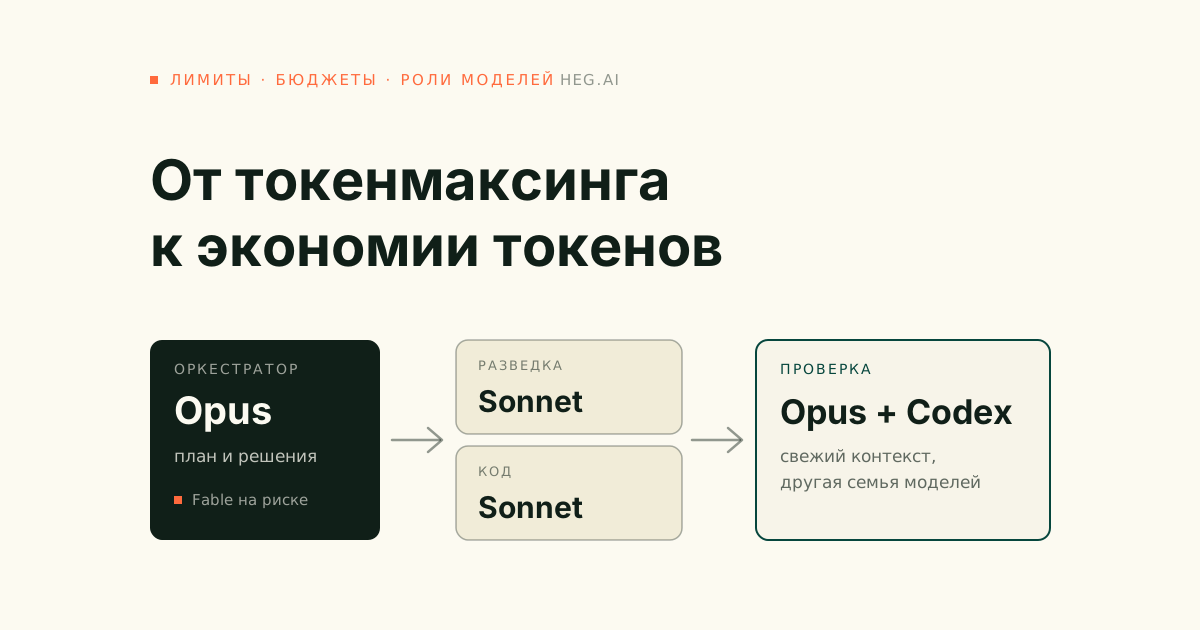
Ещё весной в Кремниевой долине было модно соревноваться, кто больше сожжёт токенов. Сейчас маятник качнулся обратно: провайдеры урезают подписки, компании вводят бюджеты на нейросети, а сами нейросети начинают считать как обычную статью расходов. Мы тоже через это прошли и перестроили работу своих агентов так, чтобы дорогая модель думала, а дешёвая делала механику.
Ниже три части: что происходит с рынком и лимитами, что мы поменяли у себя и с какими цифрами, и как повторить это в своей команде.
Эпоха токенмаксинга
Слово tokenmaxxing разошлось в марте 2026 года после колонки Кевина Руза в New York Times: компании начали учитывать расход токенов при оценке сотрудников. Логика простая: агенты дают продуктивность, значит, кто больше их гоняет, тот больше делает.
Дженсен Хуанг: если инженер с зарплатой $500 тыс. не потратил хотя бы $250 тыс. на токены, он будет «глубоко встревожен».
Внутренний рейтинг по расходу токенов среди 85 тыс. сотрудников, около 60 трлн токенов за 30 дней. Рейтинг сняли через несколько дней.
Внутренний рейтинг Kirorank: сотрудники стали запускать агентов на бессмысленные задачи ради места в таблице. В мае его удалили.
Разворот: счёт пришёл
Copilot объявил переход на оплату по токенам: «текущая модель больше не устойчива», короткий вопрос и многочасовая сессия агента стоили пользователю одинаково.
Компания сожгла весь годовой бюджет на токены за первые четыре месяца, в том числе на Claude Code. Fortune вышел с заголовком «Tokenmaxxing is dead».
Марк Бениофф: счёт компании в Anthropic за год около $300 млн. И сразу пожелание: нужен умный роутер, который отправлял бы простые запросы в дешёвые модели, а не в самые дорогие.
Колонка «Tokenmaxxing is dead, long live valuemaxxing»: расход токенов - это сигнал о затратах, а не метрика ценности.
Пожелание Бениоффа, по сути, и есть тема этой статьи. Только роутером у нас работает не отдельный сервис, а сама сильная модель, которая решает, кому из помощников отдать подзадачу.
Подписки ужимаются
Для небольших команд главный канал к моделям - подписки за $100–200 в месяц, на которых можно было выбрать работы на тысячи долларов по ценам API. Последние месяцы это окно заметно сужается. По ощущениям, лимиты в Codex за лето и осень упали раза в четыре. Проверили по источникам, и вот что подтверждается:
| Когда | Кто | Что изменилось |
|---|---|---|
| авг 2025 | Anthropic | К пятичасовым лимитам добавились недельные |
| мар 2026 | Anthropic | Пятичасовые лимиты урезали в часы пик |
| май 2026 | Anthropic | Объявили, что Agent SDK уходит с «субсидированных лимитов» подписки на отдельные кредиты. В июне паузу поставили, но слово сказано |
| сен 2026 | Anthropic | Недельные лимиты Claude Code −17% к тому, что было до 14 сентября |
| сен 2026 | OpenAI | Pro за $200 урезали вдвое: с 20 до 10 лимитов Plus. Появился Pro за $500 |
Наши «раза в четыре» по Codex подтверждаются частично. Официально тариф за $200 урезали вдвое. Ещё примерно в 1,6 раза меньше в долларах API он стал давать при переходе на новые модели, это видно по независимому замеру. В сумме выходит раза в три. Но это расчёт на замерах одного автора, и в токенах картина мягче: модели в API параллельно подешевели.
Самое показательное - как это объясняет сам руководитель Codex Тибо Сотто:
Если посчитать, новый Pro за $200 даёт половину от прежнего в долларах API. (...) Со временем цены упадут настолько, что большинству будет выгодно покупать использование по мере надобности, без заметной разницы между подпиской и API.
Тибо Сотто, X, 29 сентября 2026. Перевод наш, с сокращением
Почему так происходит, хорошо видно в разборе SemiAnalysis от 5 октября: подписки дают Anthropic около 10% выручки, но могут занимать больше 40% мощностей на инференс. Если выбирать подписку на Opus 5.5 полностью, маржа провайдера по их модели уходит в минус 369%. Долго так продолжаться не может.
Кредиты вместо безлимита
Параллельно провайдеры начали раздавать кредиты поверх подписки. Выглядит как подарок, но кредиты тратятся по ценам API, и люди привыкают считать каждый вызов.
| Когда | Кто | Что дали |
|---|---|---|
| мар 2026 | AI credits в Antigravity, $25 за 2 500 кредитов | |
| июн 2026 | GitHub | Copilot перешёл на AI Credits: подписка за $10 = $10 кредитов по ценам API |
| сен 2026 | Anthropic | Разовые $100–250 на облачные сессии Claude Code |
| сен 2026 | OpenAI | Компенсация за урезание Pro: 62 500 кредитов (≈$2 500) до конца года |
| окт 2026 | Anthropic | Ежемесячные API-кредиты: $100 на Max 5x, $200 на Max 20x. В Claude Code их тратить нельзя |
Безлимитные подписки - это субсидия на этапе захвата рынка, и она заканчивается. Сейчас подписка за $200 при полной выборке даёт работы на несколько тысяч долларов по ценам API. Думаю, через год-два это будет ближе к тысяче, а всё сверх неё - по счётчику. Поэтому оптимизация токенов сейчас очень правильная задача: кто научится получать тот же результат дешевле, тот выиграет и в скорости, и в деньгах.
Что мы поменяли у себя
Толчком стала не экономия, а надёжность. В конце сентября по знакомым прокатилась волна блокировок Claude Code без объяснения причин, задело и нас. Стало понятно, что сидеть на одном провайдере опасно: нужна обвязка, в которой любую модель любого провайдера можно подключить или выкинуть, не переделывая процесс. Такая обвязка называется харнесс: инструменты модели, её помощники и то, на каких моделях они работают.
А раз уж мы туда полезли, занялись и экономией. Opus и Fable работают очень круто, но долго и дорого, а большинству задач такой интеллект не нужен. Хуже того, оказалось, что встроенный помощник для поиска по коду наследует модель родителя: сессия на Opus гоняла поиск своими самыми дорогими токенами.
Главное: модель-менеджер
Мы теперь запускаем агента верхнего уровня на большую задачу, а он сам её раскладывает, раздаёт подзадачи агентам попроще и оставляет себе решения и сборку итога. Кажется, последним моделям уже можно отдавать цель уровня «подними конверсию продукта на 15%», а дальше они всё декомпозируют сами. Это и есть роутер Бениоффа, только встроенный в работу: дорогая модель тратит токены на суждение, дешёвая на механику.
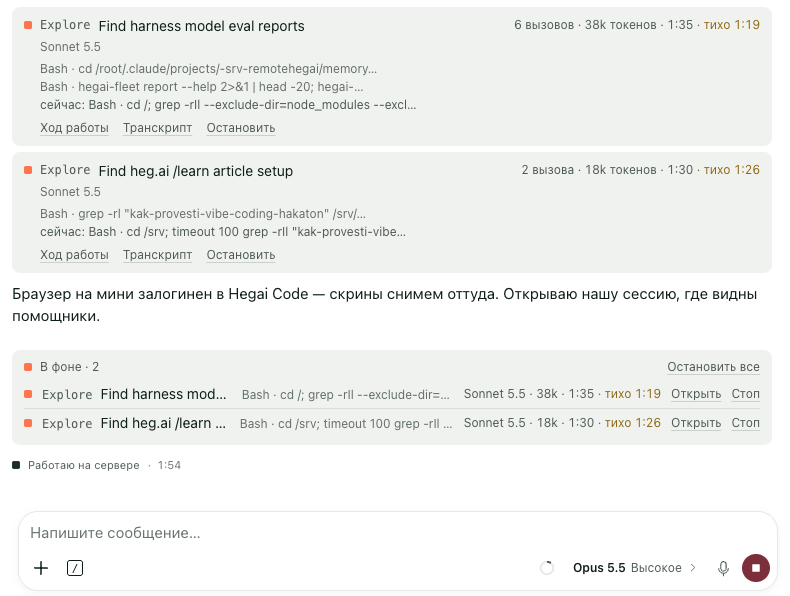
Какая модель что делает
Мы прогнали модели на реальных задачах и багах нашей платформы и Hegai Code. Короткая версия:
| Роль | Кто лучше | Почему |
|---|---|---|
| Поиск по коду | Sonnet | 6 из 6 верных ответов, как у Opus, но 15 с против 22 с. Haiku ошибся и прочитал ~200 тыс. токенов на вопрос, так что дешевле не вышло |
| Код по плану | Sonnet | Те же тесты, что у Opus, за 90 с против 110 с и $1,18 против $2,27 по прайсу. Fable - $5,01 |
| План и решения | Opus | На простых задачах план не нужен вовсе: Sonnet справлялся сам, а план добавлял ~85 с. На рискованных план пишет Fable |
| Ревью | Opus + Codex | Sonnet здесь заметно слабее (5 из 11). Пара из разных семей (в замере Fable + GPT-5.6) поймала столько же, сколько все ревьюеры вместе. Opus чуть уступает Fable, но быстрее и дешевле, поэтому по умолчанию он |
Ревьюера из другой семьи моделей мы держим только на замечаниях, а чинит код оркестратор. В исследовании июля 2026 года на 116 задачах Claude, проверяя черновики Codex, поднял долю решённых задач с 71,6% до 89,7%. А Codex, проверяя черновики Claude, опустил её с 91,4% до 82,8%.
Ревью подробнее
| Ревьюер | Нашёл из 23 | Медиана |
|---|---|---|
| Fable 5.1 | 11 | 93 с |
| GPT-5.6 | 10 | 388 с |
| Opus 5.5 | 9 | 78 с |
| GPT-6.1 (high) | 8 | 175 с |
| GPT-6.1 (xhigh) | 8 | 324 с |
| GPT-6 astra | 7 | 102 с |
| Sonnet 5.5 | 5 из 11 | 77 с |
Две вещи отсюда пригодятся и тем, кто не пишет код. Максимальное усилие модели не окупается: на xhigh GPT-6.1 нашёл столько же, сколько на high, но думал почти вдвое дольше. И чудес нет: половину багов не нашёл никто, потому что их видно только при запуске. Ревью не заменяет тесты.
Итоговая схема
| Роль | Обычная задача | Рискованная |
|---|---|---|
| План и решения | Opus | Fable |
| Поиск по коду | Sonnet | Sonnet |
| Код | Sonnet | Sonnet по плану |
| Проверка | тесты, затем Opus + Codex | тесты, затем Fable + GPT отдельно друг от друга |
Рискованная - это деньги, доступы, миграции, несколько сервисов сразу или когда нет теста, который скажет «готово». Если шлюз к модели три раза подряд не отвечает, задача уходит на Opus с пометкой: это та самая независимость от провайдера, с которой всё началось.
Одна оговорка про экономию. На подписке у Opus и Sonnet общая недельная квота, поэтому выигрыш там считается не в рублях, а в лимитах и во времени: Sonnet быстрее и ест квоту медленнее. В долларах он становится прямым, как только работа переезжает на API или кредиты, а туда, судя по всему, всё и движется.
Как повторить у себя
Дальше техническая часть для тех, кто работает с агентами в Claude Code.
Если вы работаете в Claude Code, схема собирается из двух вещей: описаний помощников и одного абзаца в инструкции главной сессии. Помощники кладутся в папку .claude/agents/ проекта, модель задаётся в шапке файла.
---
name: Explore
description: Поиск по коду и документам, когда ответ требует прочитать много мест, а важен только вывод. Возвращает находки с путями и строками, ничего не меняет.
tools: Read, Grep, Glob, Bash
model: sonnet
---
Ты ищешь ответ на вопрос в кодовой базе. Ничего не редактируй.
Верни короткий вывод: что нашёл, в каких файлах и строках, в чём уверен и в чём нет.
Не пересказывай содержимое файлов целиком.
---
name: implementer
description: Пишет код по конкретному плану. Получает файлы, нужное изменение и способ проверки; правит, гоняет проверки и докладывает, что поменял и что запускал. Не для открытого проектирования.
model: sonnet
---
Делай ровно то, что в плане. Если план расходится с кодом, остановись и опиши расхождение, не импровизируй.
После правки запусти указанные проверки (тесты, typecheck, lint) и приложи их вывод.
В отчёте: список изменённых файлов, что сделано, что запускал и с каким результатом.
---
name: reviewer
description: Свежий взгляд на дифф. Получает диапазон изменений и 3-5 строк о том, зачем они сделаны. Возвращает до пяти находок с файлом, строкой и патчем или «чисто». Только чтение.
tools: Read, Grep, Glob, Bash
model: opus
---
Ищи ошибки корректности: что сломается, на каких входных данных, в каком состоянии.
Стиль и вкусовщину не комментируй. Каждую находку подтверди сценарием отказа.
Не уверен - так и напиши, не выдавай догадку за баг.
## Распределение работы между моделями

Если ты Opus или Fable - ты оркестратор: планируешь, делегируешь, принимаешь
решения и сводишь итог. Свой контекст и дорогие токены трать на суждение,
а не на механику.

- Исследование кода - через субагента Explore (Sonnet). Несколько
  независимых вопросов - несколько Explore параллельно, одним сообщением.
  Точечный факт, когда файл и место уже известны, проще прочитать самому.
- Написание кода - когда план конкретный (какие файлы, что поменять, чем
  проверить), отдай его субагенту implementer (Sonnet). Сам пиши то, что
  требует тонкого суждения: правки в пару строк, конкурентность, безопасность.
- Проверка - после нетривиальной правки и до доклада «готово» запусти
  параллельно reviewer (Opus) и ревьюера из другой семьи моделей (например,
  Codex). Находки сверь с кодом сам: подтвердившиеся исправь, ложные отбрось
  с причиной. Для правок в документации и конфиге ревью не нужно.

Если ты Sonnet или Haiku - делай работу сам.
Второго ревьюера из другой семьи проще всего подключить через Codex CLI: команда codex review разбирает незакоммиченные изменения или ветку. Обёртка в виде ещё одного помощника, который запускает её и возвращает вывод как есть, пишется за пять минут, попросите об этом саму сессию. Подробности о помощниках - в документации Claude Code.
Честные границы
- Выборка маленькая. 23 бага, 6 вопросов, 3 задачи на код. Разница в один-два случая между моделями - шум, а не победа.
- Ложные срабатывания не мерили. Считали, нашёл ли ревьюер настоящий баг, но не сколько пустых замечаний он принёс по дороге.
- Доллары - это прайс API, а не счёт. Мы работаем на подписках, поэтому все суммы в статье - ценовой эквивалент. Реальный выигрыш сейчас в лимитах и времени.
- Часть рыночных цифр из вторых рук. Данные по Meta, Amazon, Uber и Salesforce - из пересказов The Information, FT и Business Insider в крупных СМИ. Оценки по лимитам подписок - внешние, сами провайдеры лимиты в токенах не публикуют.
- Умный роутер не взлетел. Мы пробовали дообучить маленькую модель, которая сама решала бы, какой связке отдать задачу. На 33 отложенных задачах она угадывала примерно как необученная, около половины. Пока маршрутизация по правилам из таблицы работает лучше.
Такие связки рождаются в чатах
Половина того, чем мы пользуемся сами, пришла из сообщества: кто-то поделился скиллом, кто-то показал связку моделей, кто-то принёс грабли, на которые не пришлось наступать остальным. Если вы собираете продукты с агентами и считаете на них бюджет, приходите к нам: в heg.ai есть Builder Evenings, хакатоны, курс по вайбкодингу и чаты, где отвечают практики.
Подать заявку Статья про рамблингРыночные цифры сверены с источниками ниже на 11 октября 2026 года. Замеры моделей - внутренние, heg.ai, 4–5 октября 2026, на задачах платформы сообщества и Hegai Code. Расход за неделю - по логам нашего шлюза к моделям, 4–11 октября 2026.
Источники
- Kevin Roose, tokenmaxxing. The New York Times, март 2026.
- Дженсен Хуанг про $250 тыс. на токены. R&D World, март 2026.
- Рейтинг расхода токенов в Meta. The Decoder по данным The Information, 2026.
- Amazon удалила рейтинг Kirorank. InfoWorld по данным FT, май 2026.
- GitHub Copilot is moving to usage-based billing. GitHub, апрель 2026.
- Jeremy Kahn, Tokenmaxxing is dead. Fortune, 28 мая 2026: Uber, Salesforce.
- Tokenmaxxing is dead, long live valuemaxxing. IBM, июнь 2026.
- Недельные лимиты Claude Code. TechCrunch, июль 2025.
- Лимиты Claude в часы пик. The Register, март 2026.
- Agent SDK и «субсидированные лимиты». XDA, май 2026.
- Недельные лимиты Claude Code −17%. BleepingComputer, 29 августа 2026.
- OpenAI урезала Pro за $200. Engadget, 29 сентября 2026.
- Тибо Сотто о новом Pro за $200. X, 29 сентября 2026.
- Замер расхода подписки Codex в долларах API. Inventive HQ, октябрь 2026.
- Anthropic Subscriptions Offer 5x+ More Value Than OpenAI. SemiAnalysis, 5 октября 2026.
- AI credits в Google Antigravity. DevClass, март 2026.
- 62 500 кредитов подписчикам Pro. MakeUseOf, 2026.
- Кредиты на облачные сессии Claude Code. BleepingComputer, сентябрь 2026.
- Ежемесячные API-кредиты на Max и Team. Anthropic, X, 8 октября 2026.
- Xiang et al., Cross-Model LLM Code Review. arXiv, июль 2026: кто кого должен проверять.
- Claude Code: субагенты. Документация Anthropic.